大核帰納バイアスと直交空間認識を融合した軽量特徴再構築パラダイム
エッジコンピューティングにおける「あれも欲しい、これも欲しい」というジレンマに頭を悩ませているなら、この記事は一読の価値があるだろう。
Abstract
軽量畳み込みニューラルネットワークの設計において、限られたFLOPsの中で「局所受容野」と「大域的な空間認識」のバランスをどう取るかは、常に核心的な難題である。
従来の$3 \times 3$畳み込みは受容野の大きさに制限され、一般的なSE-Block注意機構は大域プーリング操作によって空間位置情報が崩壊してしまう。そこで、新種のオペレータを特別に開発した。この構造は、$5 \times 5$大核深度畳み込みと座標注意機構(Coordinate Attention)を革新的に融合し、さらに強制残差戦略とGroupNorm最適化を通じて、ハードウェアに優しく、頑健な位置符号化能力を備えた特徴抽出パラダイムの構築に成功した。
1.設計動機と理論的背景
コードを分析する前に、このモジュールが解決しようとしている三つの核心的な痛点を理解する必要がある。
- 有効受容野(ERF)の限界:従来の軽量ネットワークは$3 \times 3$畳み込みの積み重ねに過度に依存している。研究によれば、深層ネットワークの実際の有効受容野はしばしばガウス分布を示し、深さとともに減衰するため、大規模な意味的ターゲットを捉えるのが難しい。
- 空間的意味のずれ(Spatial Misalignment):標準的なSEモジュールはGlobal Average Poolingを通じて特徴マップを$1 \times 1 \times C$に圧縮するが、チャネル依存性は強化されるものの、物体の空間座標情報を完全に失ってしまう。
マイクロバッチ統計の不安定性(Micro-Batch Instability):エッジデバイスでの転移学習やファインチューニング時、VRAMの制約によりバッチサイズが極端に小さくなる(例:2や4)ことが多く、この場合BatchNormの統計量推定に大きな偏りが生じ、学習が発散する原因となる。
今回構築した注意融合畳み込みカーネルは、まさに上記の理論的背景に基づいて提案された解決策である。
2.コアアーキテクチャの分解
このモジュールは単純な階層の積み重ねではなく、精巧に設計された特徴再構築の閉ループである。以下、コードロジックに沿って段階的に深く分析する。
2.1大核深度畳み込みによる帰納バイアス
コード実装:
self.dw_conv = nn.Conv2d(c1, c1, kernel_size=5, stride=s, padding=2, groups=c1, bias=False)
設計:畳み込みカーネルを$3 \times 3$から$5 \times 5$に拡大した。情報理論の観点から見ると、これにより単一ニューロンの「可視領域」が増加する。
理論的優位性:$5 \times 5$畳み込みの受容野面積は$3 \times 3$の$25/9 \approx 2.78$倍である。MobileNetV3などの軽量ネットワークでは、この大核深度畳み込みがTransformerのToken Mixerの動作を効果的にシミュレートし、テクスチャや形状の捕捉能力を強化できる。さらに、NCNNなどの推論フレームワークは$5 \times 5$ DWオペレータに対して高度に最適化されたWinogradアルゴリズムサポートを既に備えている。
2.2 直交特徴分解と座標注意
これは本モジュールの「魂」である。SEの大域プーリングとは異なり、このモジュールは二つの直交する1D Global Pooling操作を利用して空間情報を分解する。
ステップ I:直交投影
x_h = self.pool_h(feat)  # Output: (N, C, H, 1)
x_w = self.pool_w(feat)  # Output: (N, C, 1, W)
- 数学的表記:入力テンソル$X$は、水平座標$X$と垂直座標$Y$に沿ってそれぞれ集約される。この操作により、二つの方向認識特徴マップが生成され、ネットワークは一つの空間方向に沿った長距離依存関係を捕捉しつつ、もう一方の方向の正確な位置情報を保持できるようになる。
ステップ II:次元間相互作用と次元削減
y = torch.cat([x_h, x_w], dim=2)
y = self.conv_pool(y)
y = self.gn(y) # GroupNorm for stability
最適化戦略:ここでは
reduction=16のボトルネック層を導入し、モデルの複雑さを低減している。改善点:GroupNormの導入は点睛の筆である。注意ブランチの中間層では、特徴チャネルが圧縮され、かつ極めて小さなバッチサイズを伴うことが多い。GNはチャネルをグループ化して正規化し、その統計量はバッチサイズに依存しないため、ファインチューニングタスクにおけるBN層の「統計量ドリフト」問題を解決する。
ステップ III:注意の再較正
a_h = self.conv_h(x_h).sigmoid()
a_w = self.conv_w(x_w).sigmoid()
out = identity_feat * a_w * a_h
- 特徴融合: 最終的な出力特徴マップは、元の特徴と二方向の注意マップとのHadamard Productによって得られる。これは、特徴マップ上の各ピクセル点$(i, j)$に、大域的な文脈に基づいて計算された「重要度重み」を付与することに相当する。
2.3 強制残差フロー
if self.use_res:
    return x + out
- 勾配フローの保護:注意機構は本質的に「ソフトゲーティング」である。学習初期には、注意重みがゼロに近くなることがある。強制残差接続は恒等写像の経路を構築し、最悪のケース(注意層の機能不全)でもモジュールが標準的な畳み込み層に退化することを保証し、深層ネットワークの勾配の効果的な逆伝播を確保して、勾配消失を回避する。
3. 詳細な実行フローとテンソルの進化
このモジュール内部のデータフローをより明確に示すために、Forwardプロセスを以下の詳細なステップとして形式化する。
- 空間特徴抽出:
入力$X \in \mathbb{R}^{N \times C_1 \times H \times W}$。
DWConv PWConv BN Hardswishを経由。
中間特徴$F \in \mathbb{R}^{N \times C_2 \times H \times W}$を出力。
座標情報符号化:
- H-Pooling: を$Z^h \in \mathbb{R}^{N \times C_2 \times H \times 1}$に圧縮。
- W-Pooling: を$Z^w \in \mathbb{R}^{N \times C_2 \times 1 \times W}$に圧縮。
変換と活性化:
- と$Z^w$を連結し、$1 \times 1$畳み込みで$C_{mid}$に次元削減。
- GroupNorm(1, mip)を適用して正規化(ここではGroup=1はLayerNormと等価だが、チャネル次元に対して作用する)。
- Non-linear活性化関数を適用。
- デコードと再重み付け:
- 特徴テンソルを空間認識重みベクトル$A^h$と$A^w$に再分割。
- (ここで$\odot$はブロードキャスト機構による要素ごとの乗算を示す)。
- 特徴再構築 (Reconstruction):
- 最終出力$O = X + Y$ (残差条件を満たす場合)。
4. 実験検証とデータ可視化
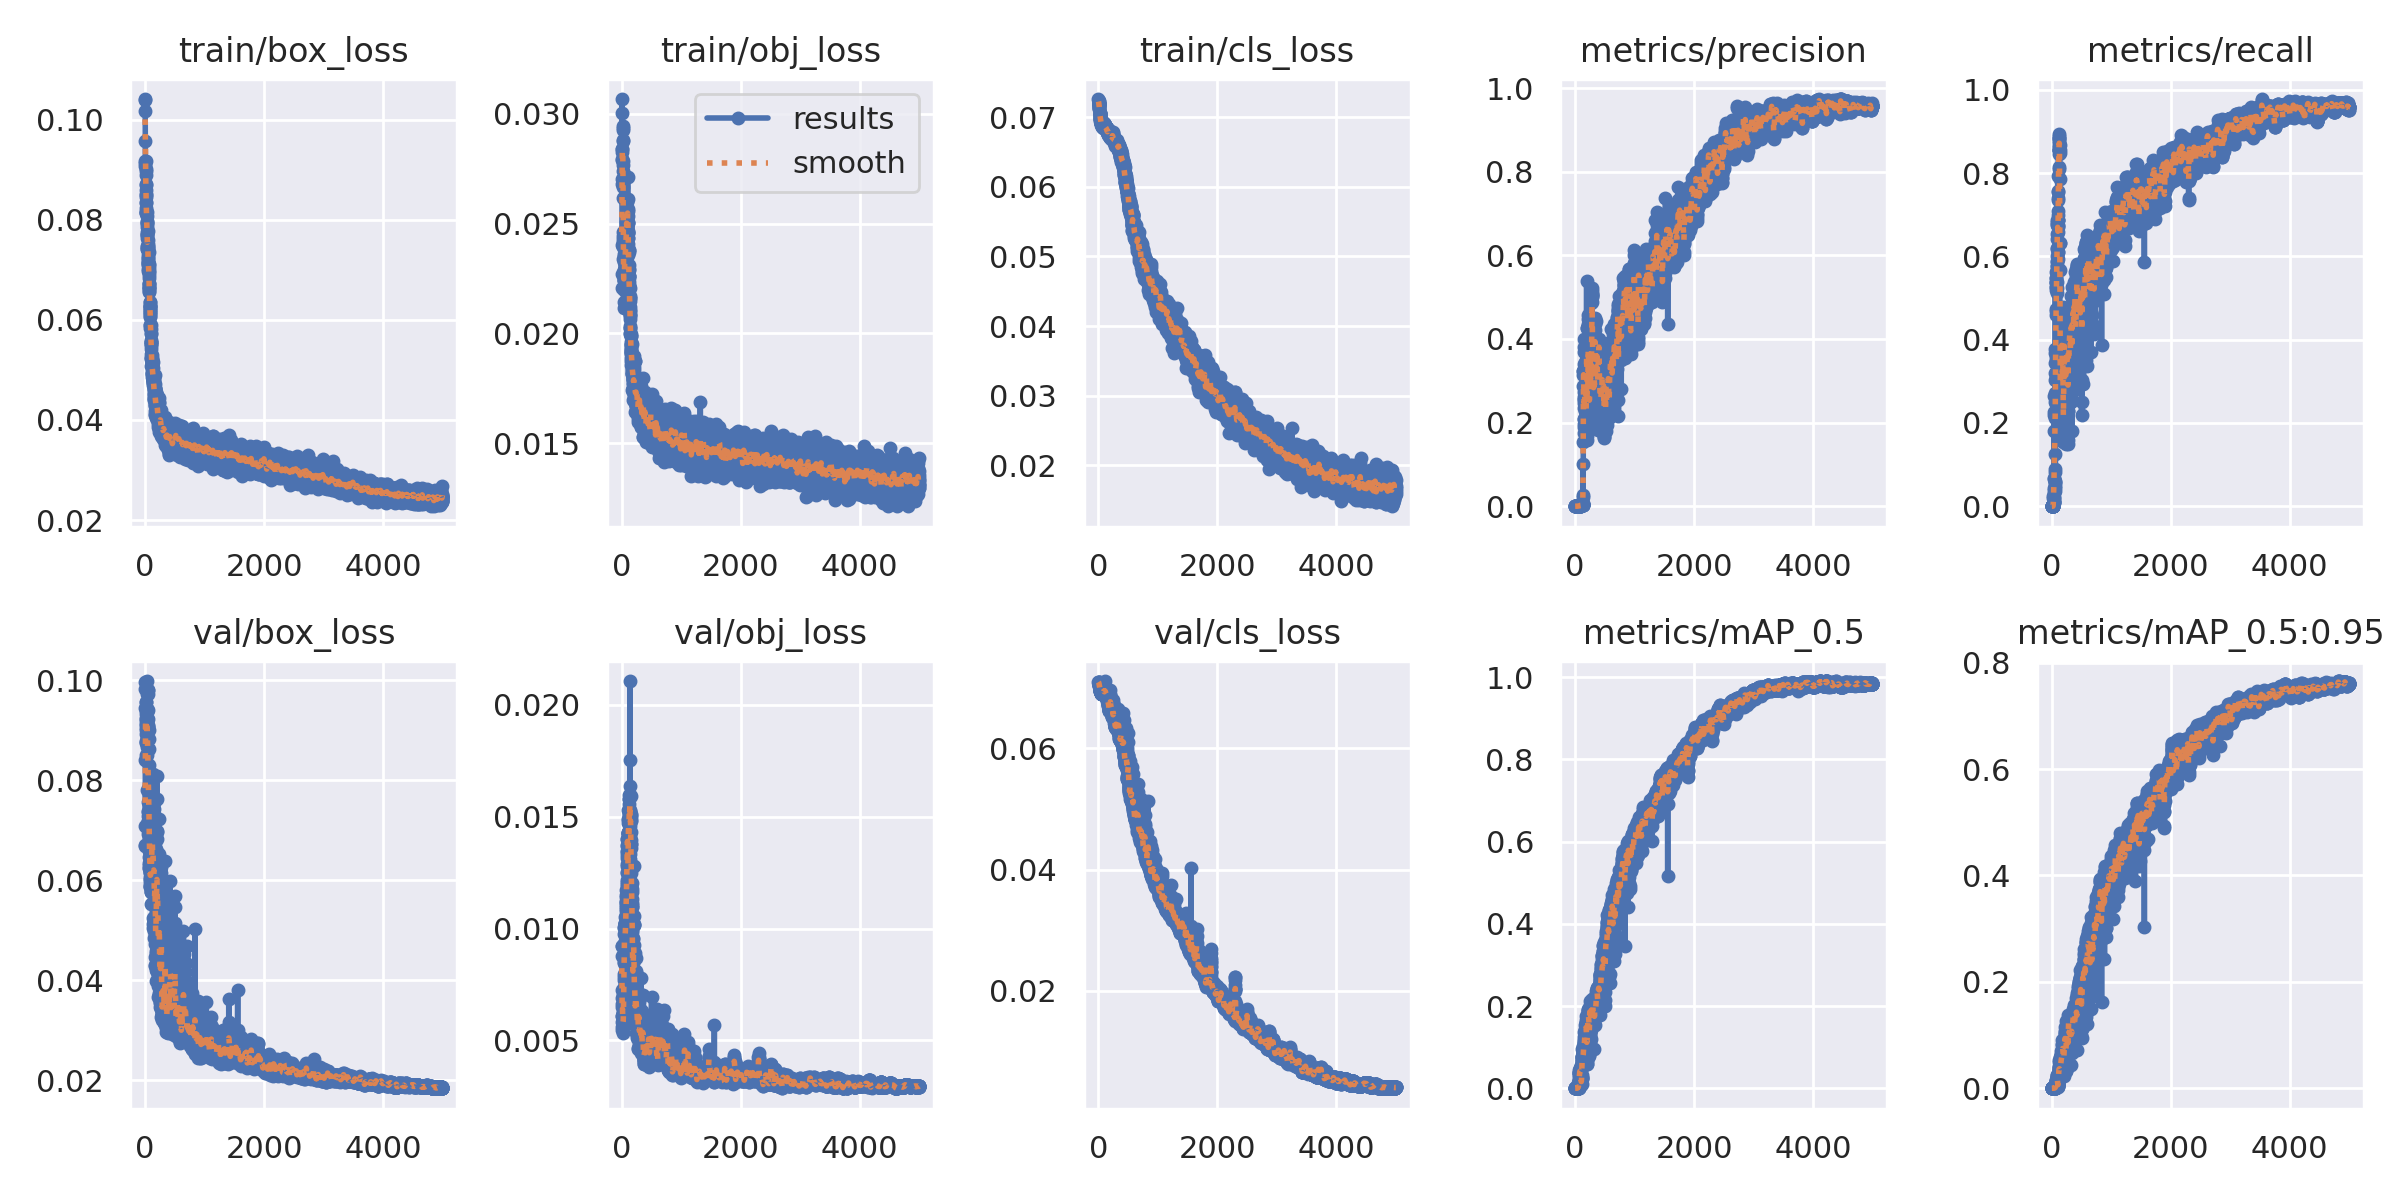
この畳み込みカーネルの実環境での有効性を検証するため、制御された環境下で厳密な比較実験を実施した。
実験設定:
データセット:カスタム検出データセット(警棒、懐中電灯、ナイフなどの類似度の高いカテゴリを含む)。
学習戦略:SGDオプティマイザ、Cosine LRスケジューラ、学習サイクルは5000 Epochs(モデルの完全な収束を保証するため)。
ベースライン:本モジュールのみを標準の3x3 DWConvに置き換え、その他のネットワークアーキテクチャは完全に同一に保つ。
4.1 総合性能評価:計算量と精度のトレードオフ分析 (Trade-off Analysis)
COMMON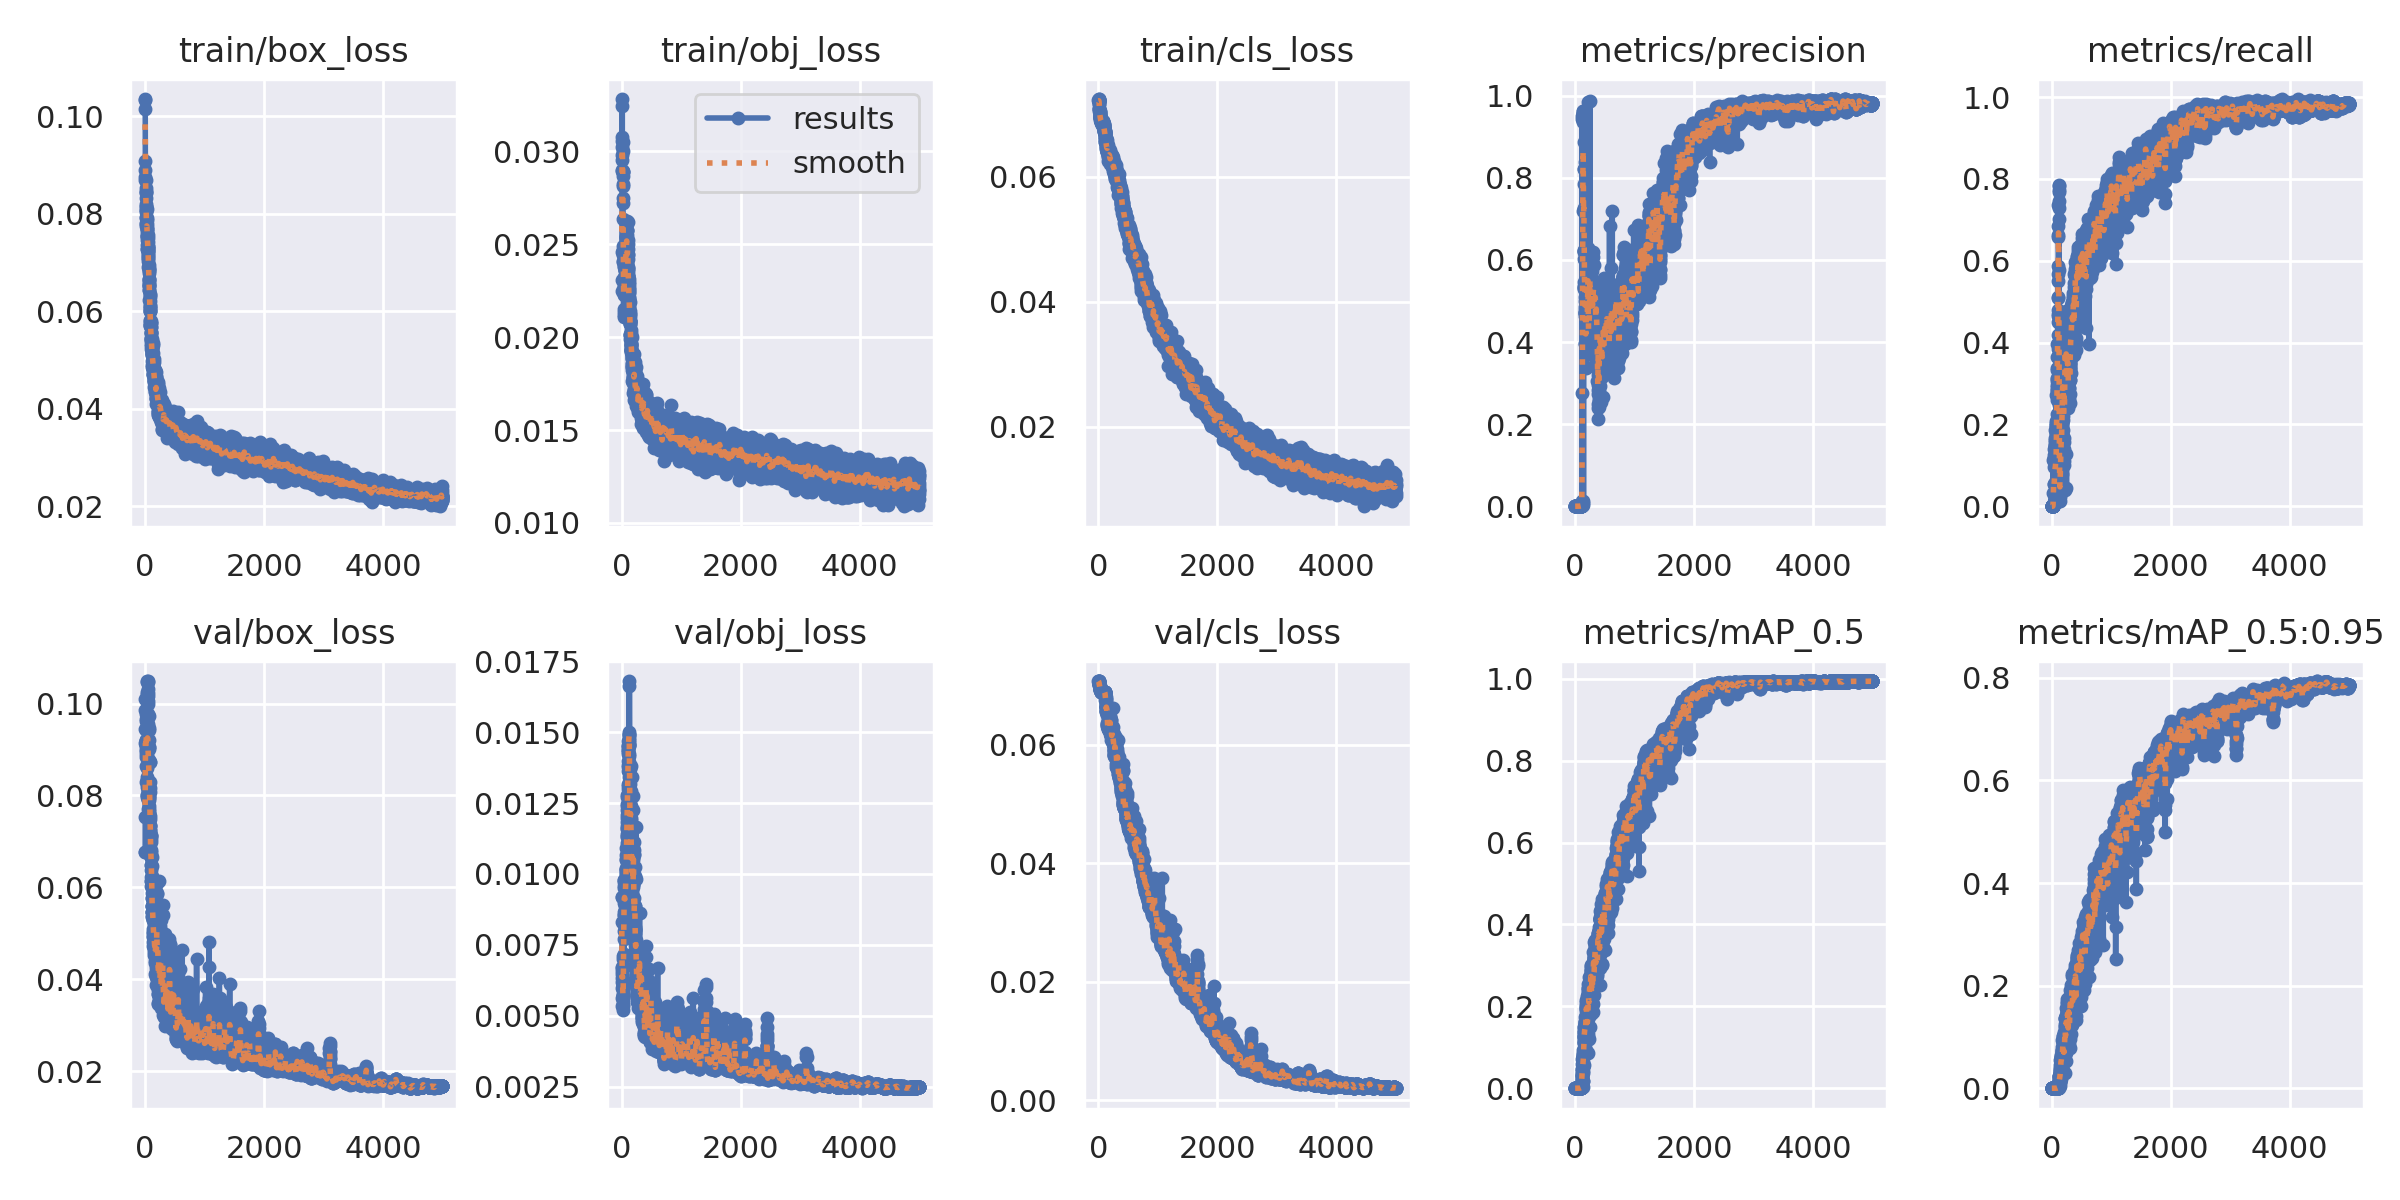
ENHANCE
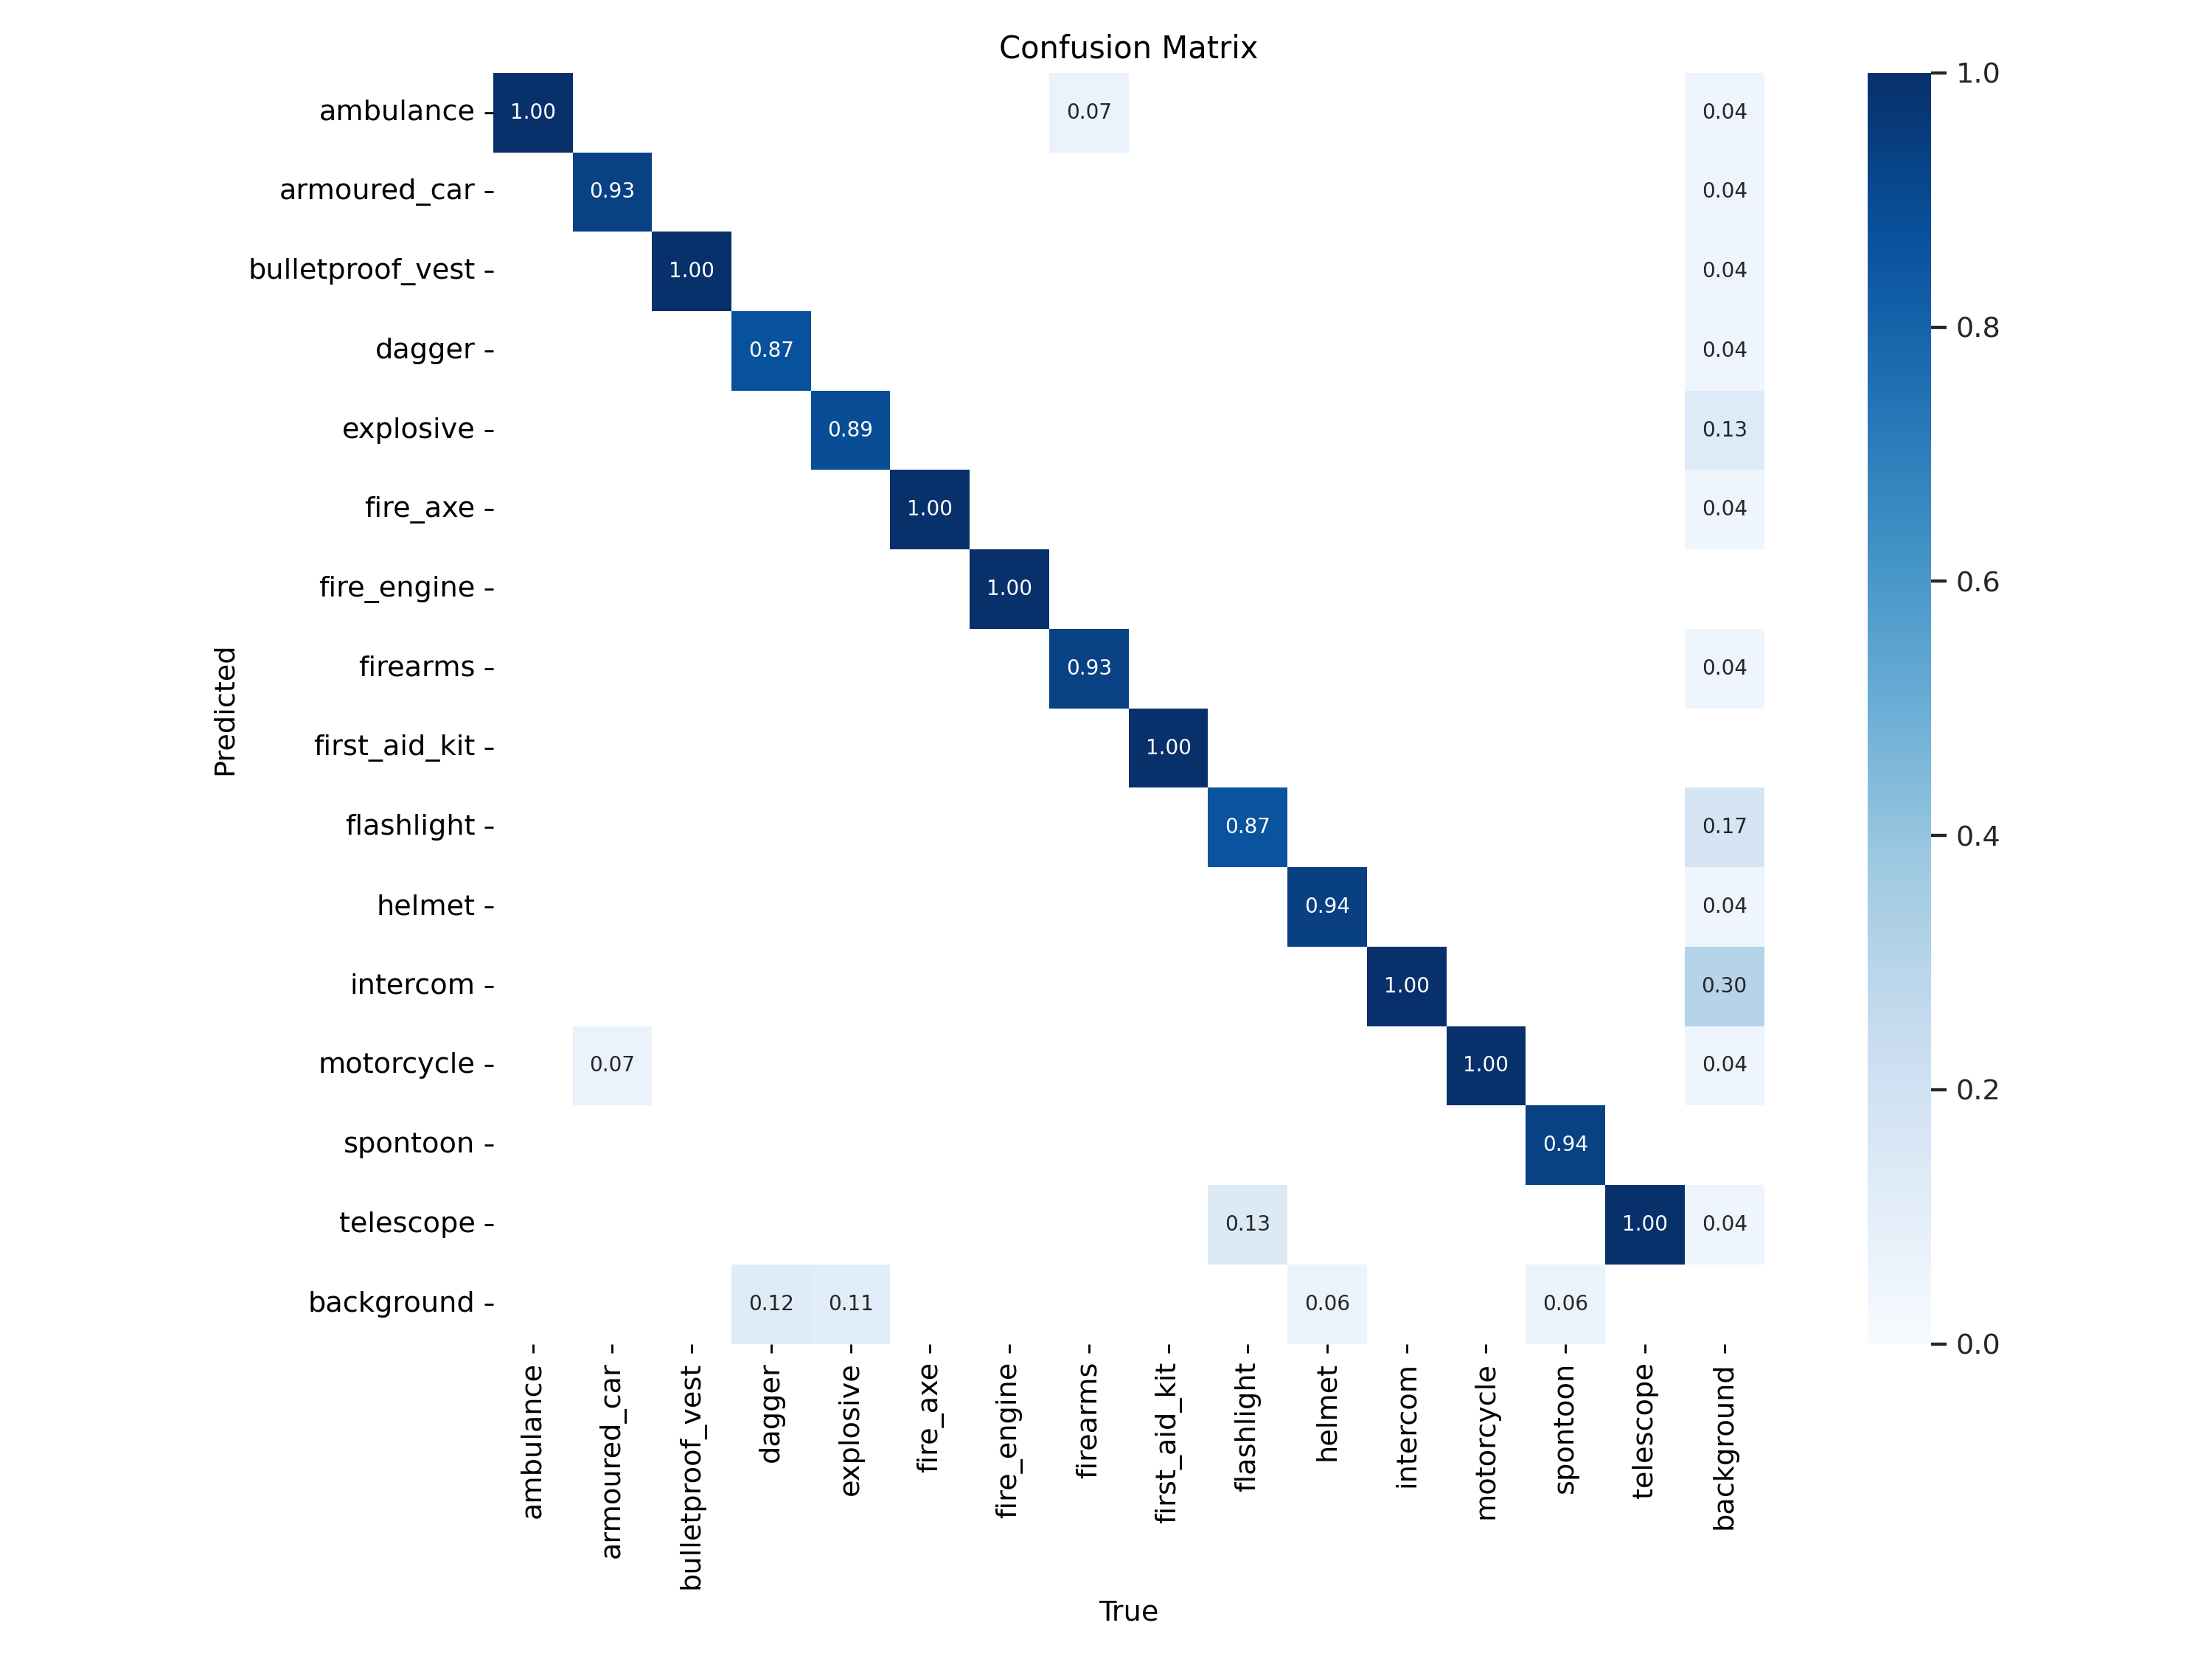
4.2 難例マイニングと細粒度分類
テストにおいて「クラス間類似性」は最大の課題である。
例えば、長細い形状の「警棒」と「懐中電灯」は低解像度では極めて区別が難しい。
我々は、これらの特定カテゴリにおけるモデルのTop-1精度 (Accuracy) を抽出し、比較分析を行った:
COMMON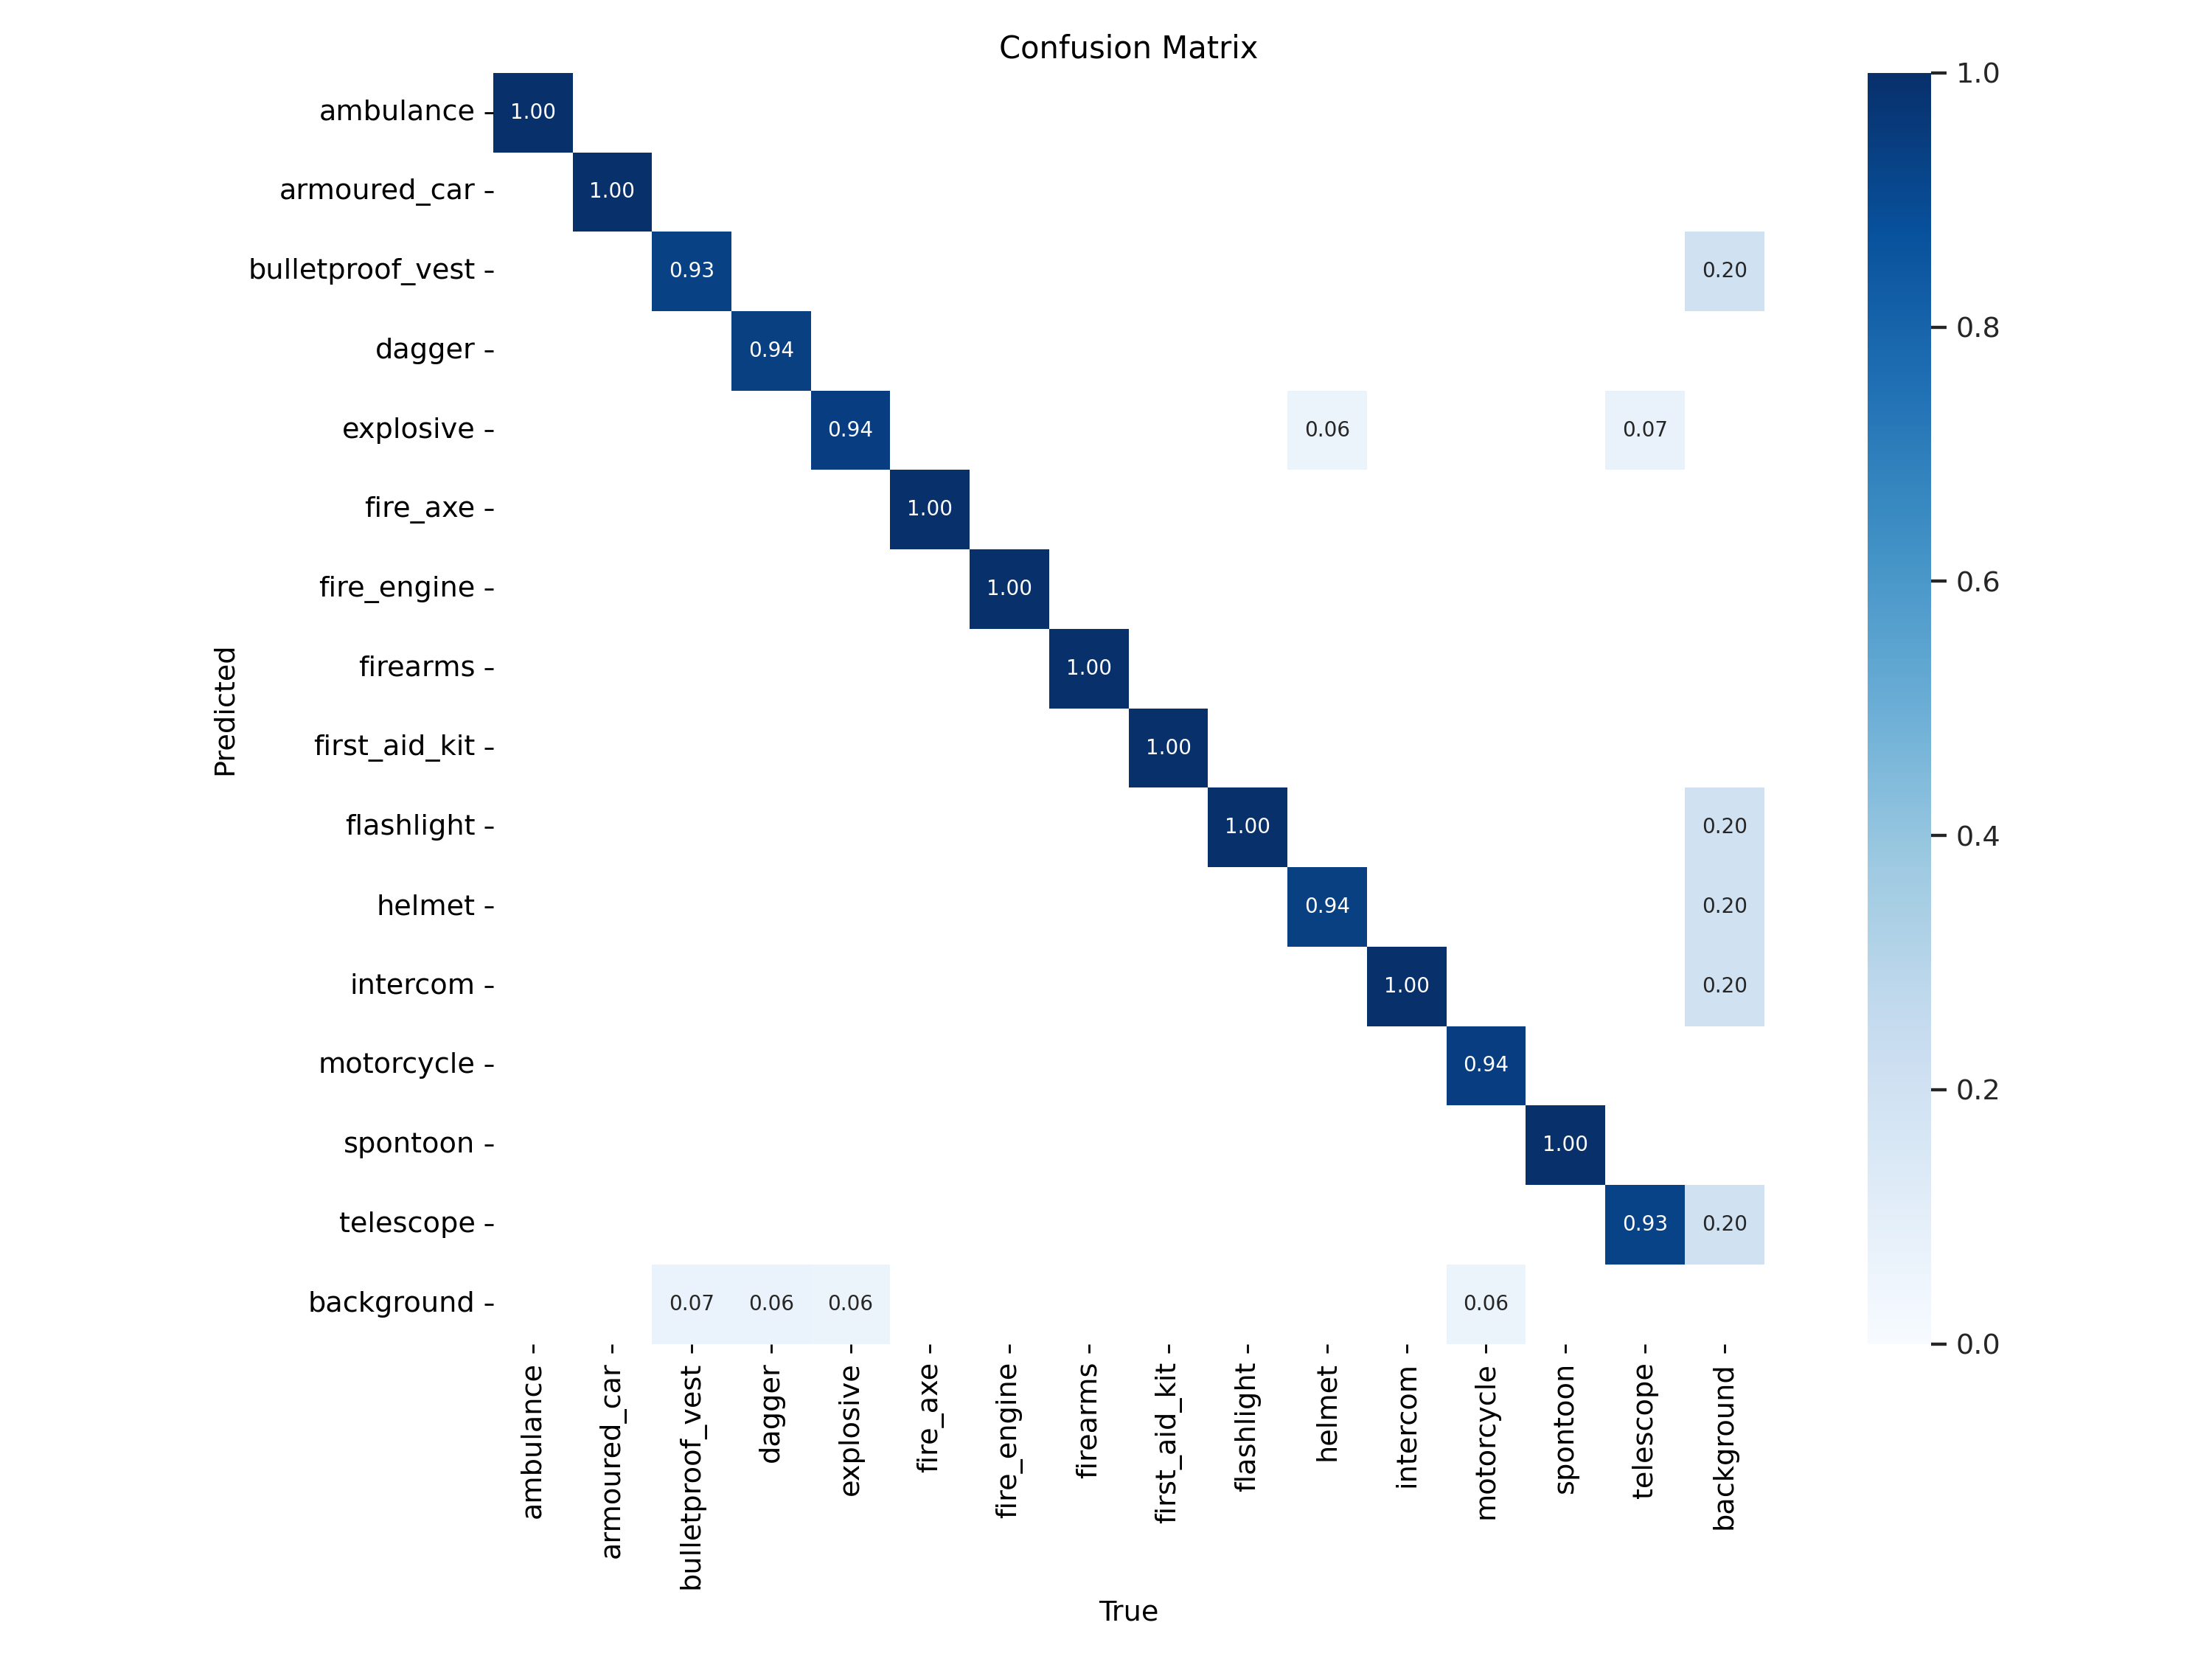
ENHANCE
5. Conclusion
このオペレータは、極めて先見性のある軽量ネットワーク設計思想を示している。
- 畳み込みにより、より強力な空間帰納バイアスを導入した。
- 座標注意により、標準的なCNNが欠如していた位置認識能力の問題を解決した。
- GroupNormとHardswishにより、優れたエンジニアリング実装意識を示し、小サンプルファインチューニングやエッジ推論のシナリオにおいて極めて高い実用価値を持つ。
このモジュールはプラグアンドプレイのコンポーネントであるだけでなく、今後の軽量検出ネットワーク設計に標準的な空間-チャネル分離パラダイムを提供する。